Soluții/Observabilitate
Observabilitate,
cap la cap, în întregul parc IT.
Telemetrie, metrici și loguri în întregul parc IT — pentru ca echipele de operațiuni să găsească cauza în loc să o ghicească, cu o retenție aliniată la obligațiile de audit.
Prezentare generală
Infrastructurile mari cedează în moduri
pe care niciun dashboard nu le poate arăta singur.
O eroare de aplicație care este de fapt latență de stocare, o întrerupere care apare doar într-un log de firewall. Instituțiile ajung cu o monitorizare fragmentată pe silozuri și fără o imagine comună. Instrumentăm platforma și tot ce rulează pe ea ca pe un singur sistem.
Servicii
Metrici și alertare
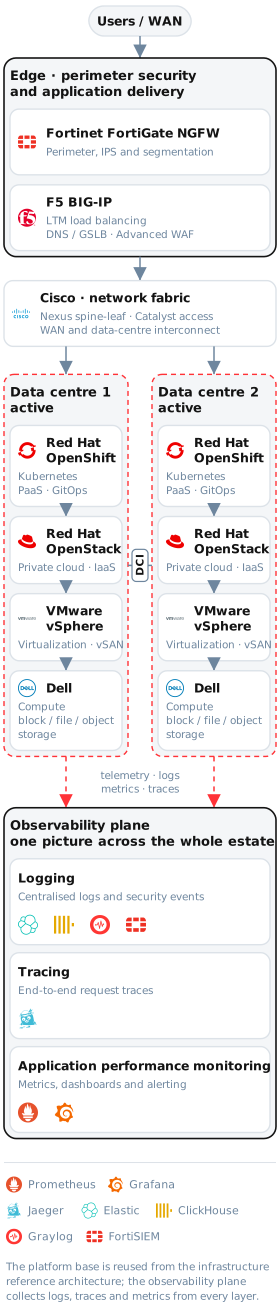
Prometheus și Grafana la scara întregului parc IT, cu rutarea alertelor aliniată la modelul de suport.
Centralizarea logurilor
Pipeline-uri ELK și Graylog Security, cu retenție aliniată la obligațiile de audit.
Tracing și performanță
Tracing distribuit cu HyperDX și bugete de latență pentru fiecare serviciu.
Telemetrie de securitate
Corelarea în FortiSIEM a evenimentelor de infrastructură, rețea și aplicații într-o singură cronologie.
Pregătire operațională
Runbookuri, definirea SLO-urilor și instruire la predare.
Tehnologiile
pe care le folosim
Întregul stack → Proiectăm observabilitatea, nu doar instrumentele: metricile, logurile și trace-urile din întregul parc IT sunt corelate într-un singur plan, pentru ca echipele să găsească cauza unei probleme în loc să o ghicească. Cele mai bune componente deschise — metrici și dashboarduri, tracing distribuit, căutare și analiză de loguri și telemetrie de securitate — sunt integrate și operate ca un singur sistem, cu o retenție aliniată la obligațiile de audit și conformitate.
Studii
de caz
Cloudul Guvernamental
Un cloud privat suveran pentru sectorul public din România — peste 500 de servere în patru centre de date Tier IV, construit integral pe Red Hat OpenShift și OpenStack.
Protecția aplicațiilor la scară largă.
Un singur strat de securitate și livrare a aplicațiilor pentru una dintre cele mai folosite platforme publice din România — peste 100 de aplicații legacy și cloud-native protejate în două centre de date, construit integral pe F5.